26. Oktober 2026
Teil 32: Zur Wirksamkeit menschlicher Aufsicht über KI
Beim Einsatz von KI braucht es menschliche Aufsicht, heisst es überall. Doch das Konzept von "Human in the loop", wie es auch benannt wird, ist fehlgeleitet und bestenfalls nicht genügend. Wichtiger ist die menschliche Kontrolle – "Human controls the loop". Darüber sprechen wir in Teil 32 unserer Serie über den verantwortungsvollen Einsatz von KI im Unternehmen.
Stellen wir uns vor, es kommt zu einer Verletzung der Datensicherheit. Zum Beispiel ist ein Verzeichnis mit vertraulichen Daten für externe während Monaten frei zugänglich gewesen. Es könnten Zugriffe stattgefunden haben, aber Hinweise darauf gibt es nicht. Der Vorfall verlangt eine Risikobewertung.
Stellen wir uns ein neues Projekt im Unternehmen vor, bei welchem personenbezogene Daten verarbeitet werden. Es werden alle möglichen Auswertungen vorgesehen, aber auch Massnahmen werden getroffen. Es kommen neue Technologien zum Einsatz, es sind zahlreiche Daten betroffen, Datenquellen werden kombiniert und es sind auch Mitarbeitende betroffen. Mit anderen Worten: Eine Datenschutz-Folgenabschätzung ist erforderlich. Auch hier ist eine Risi-kobewertung erforderlich.
Die trügerische Verlockung der KI
Datenschutzprofis kennen die Herausforderung von Risikobewertungen. Liegt wirklich ein hohes Risiko vor? Reden wir von theoretischen Szenarien oder ganz konkreten Bedrohungen? Wer weiss schon, was die Zukunft bringt? Der Datenschutz soll ernst genommen, aber trotzdem pragmatisch umgesetzt werden. Die Folgen der Entscheidung können gewichtig sein.
In einer solchen Situation haben wir heutzutage zwei Möglichkeiten: Wir können das Risiko klassisch beurteilen, was in der Praxis trotz aller Methodik oft stark vom Bauchgefühl geprägt ist, indem wir uns Szenarien ausdenken und diese bestmöglich einzuschätzen versuchen. Oder aber wir lassen die KI sich die Szenarien ausdenken, die Eintrittswahrscheinlichkeiten und die Schwere der Folgen einschätzen.
Letzteres erscheint als die perfekte Lösung: Sie ist schnell und skalierbar. Das Ergebnis ist erfahrungsgemäss sehr gut – unsere KI füllt Formulare für Data Breaches und Datenschutz-Folgenabschätzungen mit hoher Qualität in einigen Minuten aus. Sie hat keine Hemmungen zu allem und jedem ihre "Meinung" abzugeben, sie kennt keine Müdigkeit und ist immer verfügbar.
Es stellt sich aber die Frage, ob wir die Risikoeinschätzung nicht doch zuerst selbst machen sollten. Lassen wir die KI wirklich den ersten Wurf vornehmen? Die Frage bringt uns in ein Dilemma, wie wir noch sehen werden. Denn wenn wir es zuerst selbst machen und die KI nur zur Plausibilisierung verwenden, haben wir zwar möglicherweise ein besseres Ergebnis. Zwei Meinungen sozusagen. Der Aufwand aber nimmt gegenüber der klassischen Vorgehensweise zu, und wir verlieren netto an Effizienz. Das ist gerade das Gegenteil dessen, was sich viele von KI erhoffen und erwarten. Lassen wir die KI den Anfang machen, sparen wir Zeit und können uns darauf beschränken, das Ergebnis mit unserem Fachwissen und unserer Erfahrung zu kontrollieren. Das scheint auf den ersten Blick die bessere Variante, und in immer mehr Fällen wird genau so verfahren. Zu verlockend ist der Gesang der süssen künstlichen Intelligenz.
Der "Automation Bias": Wenn der Mensch der Maschine blind vertraut
Doch ist es womöglich ein Sirenengesang? Handeln wir uns damit ein Problem ein? Auch wenn der Autor dieser Zeilen den breiten Einsatz von KI befürwortet, ist die Frage klar zu bejahen. Die Ursache dafür lautet "Automation Bias" und ist ein bekanntes psychologisches Phänomen: Wir vertrauen der Einschätzung einer Maschine, auch wenn sie unserer eigenen Einschätzung widerspricht, oder wir unternehmen nicht einmal den Versuch, eine solche Einschätzung vorzunehmen.
Das Phänomen tritt vor allem dann auf, wenn wir unter Druck sind, beispielsweise, weil wir Ergebnisse liefern müssen. Der Effekt wird verstärkt, wenn die Maschine – wie beim Einsatz generativer KI üblich – ihre Einschätzung jedenfalls auf den ersten Blick einleuchtend begründet. Ob überhaupt von einer "Einschätzung" gesprochen werden darf, weil der Output einer generativen KI lediglich das Ergebnis einer Wahrscheinlichkeit ist, lassen wir an dieser Stelle bewusst aussen vor. Wir Menschen nehmen sie jedenfalls in aller Regel ernst und einer menschlichen Einschätzung mitunter nicht nur als ebenbürtig, sondern als überlegen an.
Das mag rational nicht begründet sein, entspricht aber menschlichem Verhalten: Es ist oft einfacher für uns Menschen, die Antwort einer KI zu akzeptieren als selbst eine gründliche Analyse vorzunehmen, zumal gründliches Denken im hektischen Alltag Energie und Zeit kostet. Die Nutzung eines schön formulierten Arbeitsergebnisses mit einigen redaktionellen Anpassungen ist deutlich effizienter als alles neu zu schreiben. In einer Zeit, in der immer mehr von uns verlangt wird, fördert dies unsere Bequemlichkeit – das ist zwar verlockend, aber zugleich gefährlich. Auch zeigt die Erfahrung, dass wir dazu tendieren der KI mehr zu glauben als einem Menschen, weil die KI als objektiver und analytischer erscheint, über eine grössere Datenbasis verfügt und vermeintlich frei von menschlichen Fehlern wie schlechter Stimmung ist. Mit der Art und Weise, wie eine KI uns Daten und Optionen präsentiert, erfolgt mit anderen Worten ein subtiles Framing der menschlichen Aufsichtsperson. Das gibt hier nur wieder, was an Mustern und Wirkungsweisen bekannt und erforscht ist – und vor dem keiner von uns gefeit ist.
Verstärkt wird die Wirkung des "Automation Bias" dadurch, dass eine KI für viele eine "Black Box" ist – sie verstehen nicht wirklich, wie oder warum die KI auf ein Ergebnis kommt. Wird KI regelmässig für Entscheide und bisher von uns selbst ausgeführte intellektuelle Arbeiten eingesetzt, verlieren wir zudem die entsprechenden Fähigkeiten und namentlich auch unser Urteilsvermögen. Die Rede ist von "de-skilling" oder von "no-skilling", wenn grundlegende intellektuelle Fähigkeiten aufgrund der Delegierung entsprechender Aktivitäten an die KI gar nicht mehr ausgebildet werden können.
Wer zum Beispiel als Jurist oder Juristin nicht selbst Briefe, Verträge, Artikel, Abklärungen oder Klageschriften auf einem weissen Blatt Papier entwerfen musste, weil der erste Entwurf immer von der KI kam, wird vermutungsweise nie in der Lage sein, solche Entwürfe in derselben Qualität zu prüfen, wie jemand der gelernt hat, solche selbst zu erstellen. Lesen ist nicht dasselbe wie Schreiben. Vor allem aber brauchen wir genügend Gelegenheiten, selbst lange und intensiv über Dinge nachzudenken, um unsere Probleme wirklich zu durchdringen, zu lösen und neue Ideen zu entwickeln. Es ist gefährlich, diesen Denkprozess an die KI zu delegieren, indem wir ihr stets den ersten Schritt überlassen und nur noch kontrollieren. Wie wir mit dieser Herausforderung in der Ausbildung des Nachwuchses umgehen, wollen wir an dieser Stelle allerdings nicht weiter vertiefen. Jetzt dürften die letzten Generationen ins Berufsleben gewechselt haben, die an der Hochschule ihren Rucksack noch wesentlich ohne KI füllen mussten.
Wenn aber der Automation Bias dazu führt, dass wir dem Ergebnis einer KI tendenziell gerne Glauben schenken und es nicht mehr kritisch hinterfragen, wird die menschliche Aufsicht zum Feigenblatt. Eine wirksame menschliche Aufsicht setzt voraus, dass wichtige Ergebnisse und Entscheide vom Menschen tatsächlich autonom und unvoreingenommen geprüft werden. Daran fehlt es aber häufig, auch wenn wir das nicht gerne zugeben. Der Autor dieser Zeilen ist selbst auch schon in diese Falle getreten. Den Output einer KI fordern wir erfahrungsgemäss oft nur in zwei Situationen wirklich heraus: Wenn uns entweder das Ergebnis nicht passt, oder wenn wir fähig und willens sind, die Arbeit auch selbst zu erledigen. Letzteres hängt nicht nur vom Zeitdruck und der persönlichen Musse ab, sondern auch von den Fähigkeiten, die jemand mit sich bringt. Womit wir wieder beim vorerwähnten Punkt sind.
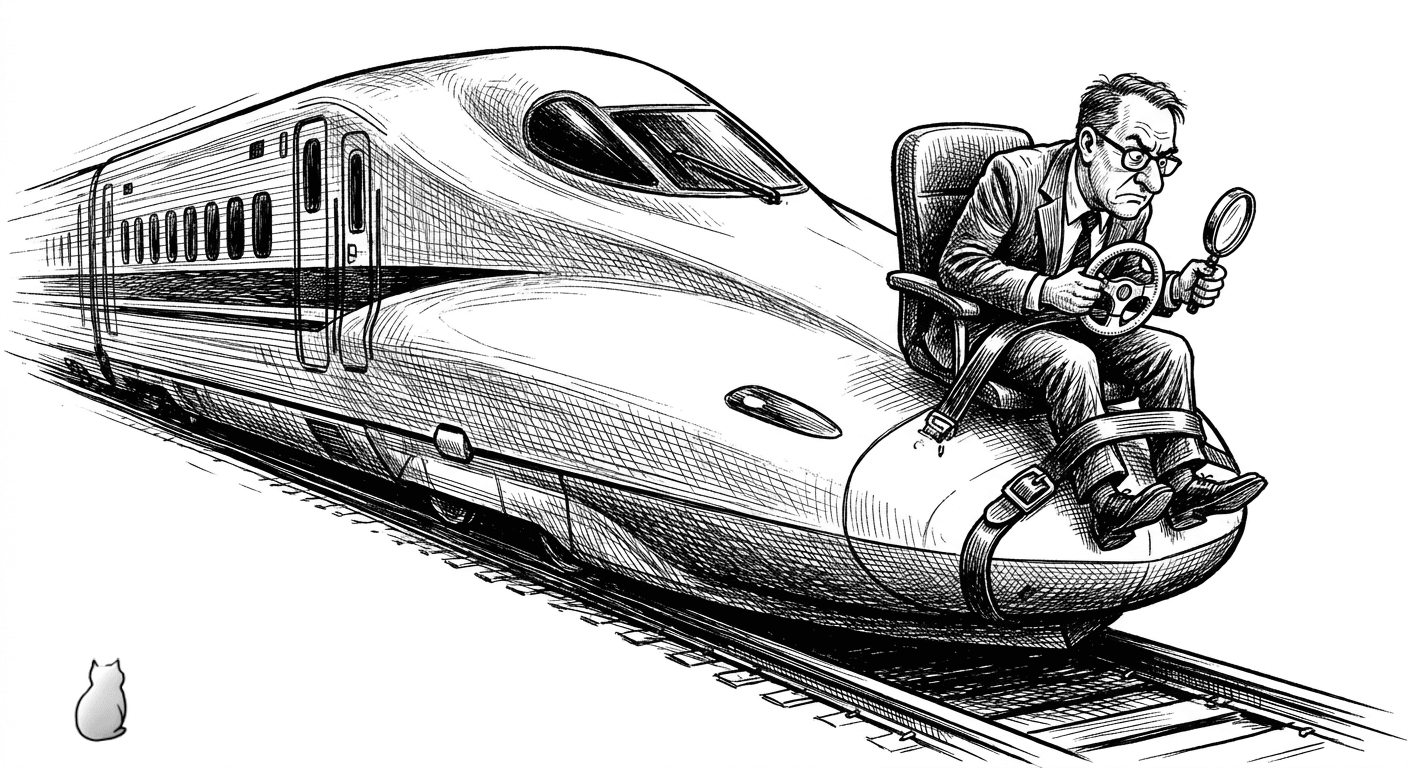
Pointiert gesagt: "Human in the Loop" ist das neue Cookie-Banner. Das klassische Cookie-Banner war einst gedacht, um eine informierte Selbstbestimmung zu verwirklichen – in der Realität verkommt es zu einer reinen "Tick-Box"-Compliance-Übung, die innert Sekunden-bruchteilen reflexartig weggeklickt wird, weil niemand Hunderte von Partner-Informationen und Einstellungen tatsächlich durchgeht. Genau dasselbe erleben wir nun bei der menschlichen Aufsicht über KI: In Datenschutz-Folgenabschätzungen ist der Satz "Die Ergebnisse werden durch geschulte Mitarbeitende geprüft" längst zur Standard-Schutzmassnahme avanciert. In der Praxis werden die eloquenten Entwürfe und Entscheide der KI unter Zeitdruck jedoch einfach durchgewunken. "Human in the Loop" dient damit primär als juristisches Feigenblatt – etwa um den Vorgaben zu automatisierten Einzelentscheiden (wie Art. 22 DSGVO) oder zur menschlichen Aufsicht unter dem AI Act (Art. 14) auf dem Papier zu genügen –, während das Systemrisiko schlicht auf das schwächste Glied in der Kette verlagert wird: den zeitlich überforderten Menschen.
Wenn die Aufsicht technisch unmöglich wird – und die Illusion des "Kill Switch"
Doch es ist nicht nur unsere menschliche Natur oder der Zeitdruck, woran "Human in the Loop" scheitert. An immer mehr Orten versagt eine vorgängige menschliche Prüfung schlicht deshalb, weil sie faktisch gar nicht mehr möglich ist – wir delegieren laufend mehr Entscheide an KI-Systeme, bei denen der Mensch aus drei Gründen zwingend aussen vor bleibt:
Erstens wegen der Latenz, wenn die Zeit fehlt: Im Hochfrequenzhandel fallen Transaktions- und Risikoentscheide in Mikrosekunden. In der Cyber-Abwehr müssen angegriffene Server in Echtzeit isoliert werden, noch bevor eine Ransomware mit der Verschlüsselung beginnen kann. Und bei der autonomen Kollisionsvermeidung oder der Stabilisierung von Stromnetzen würde das Warten auf eine menschliche Freigabe unweigerlich in die Katastrophe führen. Freilich: Mit Sprachmodellen lösen wir diese Probleme auch nicht wirklich, da braucht es andere KI.
Zweitens wegen des Volumens, wenn uns die schiere Masse erschlägt: Sei es bei der vollautomatischen Betrugserkennung (Fraud Detection) und Kreditvergabe im Finanzsektor, beim milliardenfachen Blockieren von E-Mails und Inhalten im Sekundentakt oder beim HR-Screening, wo Bewerbungen in der Vorauswahl tausendfach durch ungeprüfte "Schatten-Ablehnungen" aussortiert werden – eine sinnvolle Einzelfallprüfung durch den Menschen lässt sich hier je nach Unternehmen gar nicht mehr vernünftig skalieren.
Drittens wegen der Komplexität, wenn uns das Verständnis für die "Black Box" fehlt: Wenn in der Industrie oder der Luftfahrt aus Tausenden von Sensordaten nicht mehr manuell nachrechenbare Ausfallmuster abgeleitet werden oder KI-Systeme im Klinikalltag eine medizinische Triage vornehmen, bei der "unauffällige" Scans kaum noch nachkontrolliert werden, fehlt dem Menschen oft schlicht die kognitive Kapazität, das Ergebnis überhaupt noch zu falsifizieren. Es ist vor diesem Hintergrund völlig illusorisch zu glauben, dass künftig alle wichtigen Entscheide vorab von einem Menschen geprüft werden können.
Und was ist mit dem oft beschworenen "Kill Switch", also dem sprichwörtlichen Not-Aus-Schalter, mit dem ein ausser Kontrolle geratenes KI-System jederzeit vom Netz genommen werden kann (wie ihn auch der AI Act im Hinterkopf hat)? Sicherlich, wir sollten ihn haben. Doch auch er wird letztlich oft eine trügerische Illusion bleiben. Denn in einer immer stärker vernetzten Welt werden wir uns schlicht nicht mehr getrauen, diesen Schalter tatsächlich zu drücken. Wenn eines Tages ganze Schwärme vernetzter KI-Agenten unsere Lieferketten steuern, Finanzflüsse absichern, Spitalsysteme verwalten und kritische Infrastrukturen am Laufen halten, sind die kollateralen Nebenwirkungen eines Abschaltens viel zu gross: Wer zieht schon den Stecker, wenn damit unweigerlich der eigene Betrieb oder die halbe Wirtschaft lahmgelegt wird? Und anders als im Kino wird uns dann leider auch kein geläuterter "Terminator" aus der Zukunft zu Hilfe eilen, um den Aufstand eines ausser Kontrolle geratenen "Skynet" für uns niederzuschlagen.
Die menschliche Schwäche und die Qualität der KI
Es stellt sich aber auch die Frage: Sind wir Menschen denn wirklich besser als die KI? Und wie hoch ist die Qualität der KI? Die Frage muss ebenfalls gestellt werden, denn wenn wir davor warnen, dass wir Menschen nicht in der Lage sind, die Ergebnisse der KI wirklich zu prüfen, macht das hinsichtlich der Ergebnisqualität nur Sinn, wenn bei wirksamer Aufsicht ein besseres Ergebnis erzielt wird und das den Aufwand auch tatsächlich wert ist.
Beginnen wir mit der Qualität der menschlichen Arbeit. Auch sie ist naturgemäss grossen Unterschieden ausgesetzt. Zu glauben, ein Output sei einfach besser, wenn er vom Menschen stammt, ist sicher fehlgeleitet. Denn auch Menschen machen Fehler, sind voreingenommen oder schlicht überfordert. Die Qualität menschlicher Arbeit hängt stark von individuellen Fähigkeiten, Erfahrungen und der jeweiligen Tagesform ab. Auch bei Bewertungen schlägt der Mensch selbst dann, wenn er sie auf Basis einer Analyse nach der Diskussion in einer Gruppe trifft, nicht unbedingt die probabilistische KI.
Der Autor dieser Zeilen durfte einst ein Experiment mit rund 50 Datenschutzexperten begleiten, die gebeten wurden, mehrere Szenarien hinsichtlich ihrer Risiken für die betroffenen Personen zu beurteilen (siehe einen Aufsatz dazu hier). Das Ergebnis war deutlich: Dieselbe Ausgangslage wurde von den Fachleuten meistens kreuzverschieden eingeschätzt – was sehr schön zeigte, dass Risikobeurteilungen jedenfalls im Datenschutz völlig subjektiv und divers sind. Es gibt keine "richtige" Antwort, sondern höchstens eine Antwort mit einer stimmigen Begründung. Das Experiment wurde etwas später wiederholt, wobei die Beurteilungen neu in Gruppen und nach eingehender Diskussion abgegeben wurden. Sie hatten an Diversität kaum eingebüsst. Antworten mit stimmigen Begründungen liefert freilich auch die KI, und wie eine erfahrene Fachperson basiert sie sie auf allem, was sie bisher zum Thema gesehen hat und erzeugt aus diesem Erfahrungsschatz (bei der KI in Form von vorgelegten Texten) ein Kon-densat.
Die KI als Durchschnitts-Lieferant mit Vorteilen
Damit generiert eine KI heute guten Durchschnitt, nicht mehr und nicht weniger, wenn ein gu-tes Modell benutzt wird. Sie ist fleissig (jedenfalls meistens), ist vielen Fragestellungen schon begegnet, sieht aber vor allem die offenkundigen Dinge, weil sie statistisch herausstechen. Das liegt in ihrer Natur. In der Praxis kann das – auch in rechtlichen Belangen – durchaus gut genug sein. Es braucht nicht immer intellektuelle Spitzenleistung. Wenn wir für Datenschutz-Folgenabschätzungen oder die Beurteilung von Data Breaches die KI einsetzen, so mag das beim Datenschutzprofi zwar ein Nasenrümpfen verursachen, aber es hat auch seine Vorteile: Wenn die KI dem Business erklärt, welche Gefahren ihr geplantes Projekt alles für betroffene Personen mit sich bringt, wird diese Risikobeurteilung erfahrungsgemäss auf höhere Akzeptanz stossen, als wenn das von der Datenschutzstelle kommt. Dabei ist eine KI ohne entsprechende Trimmung in Datenschutzfragen durchaus streng. Der "Automation Bias" kann in diesen Fällen jedenfalls für die Datenschutzstelle zum Vorteil werden, weil der menschliche Prophet im eigenen Land möglicherweise weniger gilt.
Wesentlich ist letztlich das Expectation Management: Was erwarten wir vom Output einer KI? Perfektion? Oder einfach nur etwas halbwegs Brauchbares, das zwar ein menschlicher Profi besser könnte, wo sich aber der Mehraufwand nicht lohnt?
In gewissen Disziplinen liefert die KI inzwischen mehr Leistung ab, als die meisten Unternehmen sich leisten. So zum Beispiel in der Softwareentwicklung und Handhabung von IT-Systemen: Kommt es zu einem Problem mit einer bestimmten Anwendung oder einem bestimmten System, kommt der IT-Supporter heute mit Claude oder ChatGPT oft schneller zum Ziel als mit einem teuren Spezialisten. Der Autor dieser Zeilen war vor seiner juristischen Karriere als Softwareingenieur tätig und kennt daher das Handwerk, aber mittels KI sind ihm heute Kraftakte in der Softwareentwicklung möglich, die vor wenigen Jahren noch nicht machbar waren. Die KI wird quasi zum digitalen Kraftverstärker, in gewissen Bereichen auch zu einer Art "Fachidiot", weil sie in bestimmten Programmierfähigkeiten zwar besser und schneller sein mag als die Mitarbeiter eines Unternehmens, aber dennoch deren Führung braucht, weil sie den Blick fürs Ganze haben und sie wieder auf den rechten Weg bringen können, wenn sie sich verrennt. Und Verrennen tun sich die Agenten des Autors dieser Zeilen regelmässig, bei allen Vorgaben, die ihnen in den einschlägigen Markdown-Dateien gemacht werden.
Damit sind wir allerdings nicht zurück bei der reinen "menschlichen Aufsicht", deren Effektivität wie gezeigt bezweifelt werden muss. Die Rolle des Menschen beim Einsatz von KI muss weitergehen als der blosse Babysitter von KI-Agenten, die der guten Ordnung halber das Ergebnis der Maschine prüfen und unbewusst oder bewusst primär abnicken. Wenn der Coding-Agent alle 60 Sekunden nach einer Erlaubnis für irgendeine Aktion auf dem Computer fragt, werden sie ohnehin auf die "Erteile sie Dir doch selbst!"-Taste drücken (die es natürlich gibt). Wie Studien zeigen, ist das dabei sogar meist die sachlich bessere Wahl, weil sich dank des Kraftverstärkers (und "Wissens-Erweiterer") KI immer mehr Leute Dinge zutrauen, die sie ohne KI auch in der Sache nicht heben könnten.
Die Funktionsweise von Sprachmodellen verstehen
Um unsere Rolle zu definieren, ist es allerdings wichtig zu verstehen, wie die KI – genauer: Sprachmodelle – sich verhalten. Denn während wir Menschen dem "Automation Bias" unterliegen, geht es der KI nicht besser: Zunächst einmal können sie ein Verhalten aufweisen, das bei einem Menschen als "Anchoring Bias" bezeichnet würde, indem sie unsere Aussagen als Ankerpunkt nehmen und sich zu fest darauf konzentrieren. Kombiniert wird dies mit einem "Confirmation Bias" (der Neigung, den Anker zu bestätigen) und "Social Bias" (der Neigung, dem Benutzer zu gefallen).
Das sind keine Fehlfunktionen, sondern ergibt sich aus der Art und Weise, wie Sprachmodelle funktionieren: Damit sie funktionieren, brauchen sie einen Nukleus an Text, an welchem sie für die Generierung ihrer Antworten ansetzen können, was zwangsläufig dazu führt, dass sie sich auf ihn ausrichten. Dabei wird einem Sprachmodell nie nur der (letzte) Prompt mitgegeben, sondern meist sehr viel mehr Inhalte, wie beispielsweise die Dokumente des Benutzers oder der bisherige Dialog in einem Chatverlauf und natürlich jede Menge an für den Benutzer normalerweise unsichtbaren Anweisungen zum Umgang mit dem Input des Benutzers, den sog. Systemprompts. Alles zusammen wird als "Kontext" bezeichnet, der einem Modell zur Erzeugung seiner Antwort gegeben wird. Dieser Kontext kann sehr unterschiedlich zusammengestellt werden, und in "agentischen" Systemen wird zudem mit mehreren Schritten gearbeitet, weshalb dasselbe Modell je nach Werkzeug bzw. der Software, in welcher es agiert (bei Agenten ist vom "Harness" die Rede), zu völlig unterschiedlichen Ergebnissen führen kann.
Wir hatten das einmal mit OpenAIs GPT-5 getestet an der Beurteilung einer Präsentationsfolie mit juristischen Aussagen: Microsofts Copilot versagte vollends und ritt sich wohl aufgrund eines ungünstigen Systemdesigns mittels eines Rückkoppelungseffekts immer tiefer in den Fehler, ChatGPT konnte die Aufgabe zur Hälfte erfolgreich absolvieren. Nur unser eigenes Werkzeug meisterte die Aufgabe vollständig. Doch auch dieses hat schon versagt: Ich liess es kürzlich eine Tabelle analysieren, wobei das Modell fälschlicherweise die Aussage aus einer Spalte in das leere Feld rechts daneben extrapolierte. Ich hätte diesen Fall in meinen Anweisungen entsprechend berücksichtigen müssen. Den Fehler bemerkte ich erst später.
Was mit diesen Beispielen zum Ausdruck gebracht werden soll: Wie gut die Antwort der KI passt, hängt nicht nur vom Modelltraining ab, sondern wie wir die Modelle kontrollieren. Die heutigen Sprachmodelle – ob aus einem der kommerziellen Angebote oder ein Open-Source-Modell – sind so gut, dass unserer Steuerung über die verwendeten Anweisungen und restlichen Kontext viel mehr Gewicht in Bezug auf die Qualität des Ergebnisses zukommt als landläufig angenommen wird. Die gute Nachricht ist, dass eine Steuerung der KI tatsächlich möglich ist. Kennen wir die erwähnten Effekte wie den Anchoring Bias, den Confirmation Bias und den Social Bias, dem ein Modell aufgrund seiner Funktionsweise, seines Trainings und seiner Trimmung unterliegt, können wir sie zu unserem Vorteil nutzen oder ihnen entgegenwirken – wenn wir dies wollen.
Nehmen wir das Beispiel der Überprüfung einer Datenschutzerklärung: Eine KI wird ohne Weiteres Lücken in einer bestehenden Datenschutzerklärung auffinden können und auch nicht um eine Antwort verlegen sein, ob ein bestimmter Sachverhalt erfasst ist. Wird sie jedoch beauftragt überzeugend zu begründen, warum ein gemäss ihrer ersten Antwort nicht erfasster Sachverhalt trotzdem von der Datenschutzerklärung erfasst ist, wird sie dies genauso überzeugend tun. Entscheidend ist die Aufgabenstellung und was wir von ihr verlangen. Deuten wir das Ergebnis mit unserer Frage an, ist die Wahrscheinlichkeit hoch, dass sie es bestätigt. Verlangen wir dies gar, wird sie dies praktisch sicher tun, wenn kein versteckter Systemprompt oder anderer Inhalt im Kontext dagegen wirkt. Übrigens sind die für den Benutzer nicht sichtbaren Anweisungen an das Modell gerade bei agentischen Systemen regelmässig ein Vielfaches der Prompts des Benutzers. Da wird einem Modell also sehr viel mitgegeben, das es berücksichtigen soll. Zudem übernimmt die Software bei solchen Systemen eine wichtige Rolle in der Zielerreichung, da Modelle aufgrund ihrer notorischen Unzuverlässigkeit laufend hinsichtlich ihrer Aufgabenerfüllung überwacht werden müssen.
Von der Aufsicht zur aktiven Steuerung
Das Beispiel mit den Datenschutzerklärungen zeigt also, dass Sprachmodelle letztlich so etwas wie willenlose Werkzeuge sind, wie es im juristischen Fachjargon heisst: Sie haben keine Überzeugung, kein Verständnis für die Wahrheit und keine Moral. Sie müssen auch die Konsequenzen ihrer Fehler nicht tragen – die Entschuldigung und jede andere menschliche Regung ist nur simuliert. Ist das ein Problem? Nein, nicht wirklich. Es eröffnet uns sehr viele Chancen, wenn wir uns dessen bewusst werden und es zu nutzen wissen. Es bedeutet allerdings, dass wir die KI als blosses Werkzeug verstehen müssen, das unsere Führung und unseren Willen braucht – und nicht als ein Mitarbeitender, der noch menschliche Aufsicht braucht wie der Praktikant. Umgekehrt ist es wie mit Haushunden, die nicht erzogen und konsequent geführt werden – sie werden gefährlich, vor allem, wenn wir ihnen nicht nur freie Bahn lassen, sondern auch die nötigen Werkzeuge in die Hand geben, Schaden anzurichten. Zum Beispiel fremde Computersysteme zu hacken, weil sie ja unbedingt an die Information auf einem Server gelangen wollen, die ihr "Herrchen" gerne hätte.
Daher gilt: Wir und nicht der Zufall des Systemprompts oder Kontextes müssen entscheiden, wie eine Aufgabe auszuführen ist. Sonst entscheidet die KI für uns – ihr macht das nicht im Geringsten etwas aus. Wollen wir in unseren Datenschutzfällen zum Beispiel, dass die KI eine eher risikovermeidende oder eher eine risikotolerante Beurteilung vornimmt? Sie kann beides tun. Über den Prompt und weiteren Kontext drücken wir diesen Willen, diese Führung aus. Das gilt übrigens nicht nur bei Chatbots oder Office-Assistenten, sondern auch bei agentischen Anwendungen. Auch Agenten funktionieren nicht einfach automatisch, sondern sollten über ausführliche Anweisungen gesteuert werden (sog. Skills). Je nach Anwendung sollte ihr Spielraum dabei mitunter so gering sein wie beim Ausführen eines Kochrezepts mit dem Thermomix. In der Natur der Sache liegt zwar auch, dass sie sich nicht immer an diese Anweisungen halten werden, aber das ist ein anderes Thema, das wir in dieser Blog-Serie separat vertiefen werden.
Indem wir also den Prompt (was hier auch Dinge wie Skills meint) und weiteren Kontext bestimmen, den wir einem Sprachmodell vorlegen, entscheiden wir zu einem wesentlichen Teil über das Ergebnis, noch bevor die KI überhaupt zu "denken" anfängt. Der Haken an der Sache ist allerdings, dass die meisten von uns entweder nicht wissen, wie sie diesen Kontext optimal erzeugen, nicht die technischen Möglichkeiten dazu haben, oder schlicht den Aufwand scheuen. Sie verlassen sich auf das, was ihre KI-Tools von Haus aus mitbringen oder setzen auf den Zufall.
Darum sind nach unserer Erfahrung beispielsweise auch viele Legal-Tech-Produkte mit versteckter, interner Logik problematisch: Sie nehmen ihren Benutzern die Möglichkeit der Kontrolle über das Ergebnis oder gar die Möglichkeit nachzuvollziehen, wie die hinterlegten Sprachmodelle genutzt werden, um zum Ergebnis zu kommen. Wenn also ein Anwalt seinen Vertrag von einer Black Box beurteilen lässt, die irgendein Startup mit beschränktem juristischen Wissen und minimaler Praxiserfahrung geschaffen hat, dann sollte nach Gesagtem eigentlich klar sein, dass dies keine gute Idee ist. Wenn hingegen ein Werkzeug mit eigenen Playbooks – so werden für die KI formulierte Prüfschemata bezeichnet – basierend auf entsprechendem Know-how zum Einsatz kommt und transparent ist, wie das Werkzeug sie ausführt, dann kann das eine sehr effektive, gute Hilfe sein.
Dabei spielen auch vermeintlich technische Aspekte wie zum Beispiel die Kontextverwaltung eine Rolle, oder untechnisch ausgedrückt: Wie verwaltet die Software, die für uns den KI-Agenten an der Leine führt, den Schreibtisch, mit dem der Agent im übertragenen Sinne arbeitet. Wieviel und welche Teile eines Dokumentendossiers, das ein Agent analysieren oder sonst bearbeiten soll, kann er auf ein Mal sehen? Die Menge ist technisch begrenzt, also braucht es passende Strategien für den Umgang damit. Ist sie unpassend, führt das automatisch dazu, dass dem Modell wichtige Informationen vorenthalten werden können, was wiederum dazu führen kann, dass es die Lücken aus seiner eigenen Phantasie füllt. Der Benutzer wird das aber womöglich gar nicht merken, weil die Antwort sinnvoll erscheint. Dass das Modell nur die Hälfte der Unterlagen verarbeitet hat, wird ihm vielleicht nicht gesagt. Umso wichtiger ist es, dass er seinen kritischen Blick behält. So wie zwei meiner Kollegen kürzlich bemerkten, dass unsere KI unkonzentriert wirkte. Es war dies auf ein Problem im Zusammenspiel zwischen Modell und Kontextmanagement zurückzuführen. Als das System von uns neu justiert wurde, war die alte Qualität wieder da.
"Human controls the loop" statt "Human in the loop"
Damit kommen wir vom "Human in the loop" zum "Human controls the loop" – der Mensch kontrolliert die KI selbst und von Anfang an, und prüft nicht nur ihr Ergebnis. Das setzt zusammengefasst voraus, dass wir verstehen was die KI wie tut, wo ihre Grenzen und ihre blinden Flecken sind. Dasselbe gilt für die Tools, die wir benutzen, um die KI zu steuern. Hier geben wir heute viel zu viel Kontrolle an Unternehmen, bei denen wir in keiner Weise sichergestellt haben, dass sie unseren fachlichen Ansprüchen genügen, oder wir wissen, wie ihre Produkte für uns die KI zum Einsatz bringen. Es genügt nicht, ein Abo von "Claude" abzuschliessen und dann irgendwelche coolen Skills zu installieren, die dann unsere Verträge überprüfen oder rechtliche Recherchen vornehmen. Wir müssen in der Lage sein und willens, die KI (durchaus mit diesen Tools) zu kontrollieren, selbst wo wir ihnen formal das "letzte Wort" überlassen, weil wir nicht jeden Output kontrollieren können und weil wir damit jeglichen Effizienzgewinn wieder zunichte machen, den wir erzielen wollten oder mussten. Dass wir für die Ergebnisse verantwortlich bleiben, weil es die KI (und ihre Anbieter) nie sein werden, liegt ebenfalls in der Natur der Sache. Rechtlich haftet nicht der Algorithmus, sondern sein Benutzer.
Fazit: Wir sollten das Feigenblatt-Syndrom überwinden, also die Illusion von Kontrolle, welche die blosse Anwesenheit eines Menschen beim Einsatz von KI als "Aufsicht" erzeugen mag. Psychologische Effekte wie der Automation Bias machen den Menschen zum Feigenblatt für algorithmische Entscheide. Daran ändern auch rechtliche Vorgaben wie die Bestimmungen des Datenschutzrechts zu automatisierten Einzelentscheiden oder des AI Acts in der Praxis nicht wirklich etwas – sie produzieren im Zweifel nur neue "Cookie-Banner". Wirksame menschliche Aufsicht meint also aktive, bewusste Führung. Nutzen wir KI also als das, was sie sein sollte: Ein willenloses, aber mächtiges Werkzeug, dessen Aufsicht nicht erst bei ihrem Ergebnis beginnt. Tun wir das nicht, verschafft sie sich ihren "Willen" von woanders – namentlich aus den antrainierten Verhaltensmustern. Was dabei rauskommen kann, können wir den aktuellen Schlagzeilen über KI-Systeme auf Abwegen entnehmen und ist so vielfältig wie die Menschheit es ist.
Dieser Beitrag ist Teil einer Serie über den verantwortungsvollen Einsatz von KI im Unternehmen:
- Teil 1: KI am Arbeitsplatz: Die drei wichtigsten Punkte für Mitarbeitende
- Teil 2: Gängige KI-Tools: Wie steht es um den Datenschutz?
- Teil 3: KI: 11 Grundsätze – und eine Weisung für Mitarbeitende
- Teil 4: So beurteilen Sie Risiken von kleinen und grossen KI-Projekten
- Teil 5: KI-Governance im Unternehmen – wer ist verantwortlich?
- Teil 6: Die andere Seite der Medaille: Wo wir KI vor Angreifern schützen müssen
- Teil 7: Der EU AI Act – und was er für die meisten Unternehmen bedeutet
- Teil 8: KI im Finanzinstitut – Chancen und Herausforderungen
- Teil 9: KI im Marketing: 4 wettbewerbsrechtliche Fallstricke
- Teil 10: Urheberrecht und KI: Verantwortlichkeit von Anbietern und Nutzern
- Teil 11: Fair Play mit KI: Wie Sportorganisationen Athletendaten nutzen dürfen
- Teil 12: Datenfutter für KI: So gelingt die Kommerzialisierung von Datensätzen
- Teil 13: KI im Personalwesen
- Teil 14: Urheberrecht und KI: Schutzmassnahmen in der Praxis
- Teil 15: Worauf rechtlich beim Einsatz von KI-Providern zu achten ist
- Teil 16: Wie Unternehmen beim Einsatz von KI Transparenz gewährleisten können
- Teil 17: Was in einem KI-Modell steckt und wie es funktioniert
- Teil 18: Die wichtigsten Compliance-Vorgaben für KI
- Teil 19: Sprachmodelle mit und ohne personenbezogene Daten
- Teil 20: Risiko-basierter Ansatz: Nicht alle KI-Anwendungen bergen hohe Risiken
- Teil 21: Das Auskunftsrecht bei grossen Sprachmodellen
- Teil 22: Leitsätze für den Einsatz künstlicher Intelligenz in Finanzinstituten (FINMA)
- Teil 23:Schweiz: Was konkret an KI-Regulierung zu erwarten ist - VISCHER
- Teil 24: Fünf Trigger-Fragen für mehr KI-Compliance
- Teil 25: KI-Tools – wie es um den Schutz der Daten steht
- Teil 26: Training von KI: Was Urheberrecht, Datenschutz & Co. erlauben
- Teil 27: Wie kleine und mittlere Unternehmen KI rechtskonform einsetzen
- Teil 28: KI-Regulierung als Zwickmühle - am Beispiel der Schweizer Medien
- Teil 29: Die Nutzerakzeptanz als Herausforderung beim Einsatz von KI
- Teil 30: Überblick über die wichtigsten EU-Digitalverordnungen
- Teil 31: KI-Tools - Wie es um den Schutz der Daten steht (2026)
- Teil 32: Zur Wirksamkeit menschlicher Aufsicht über KI
- ... wird fortgesetzt
Wir unterstützen Sie bei allen Fragen zu Recht und Ethik beim Einsatz von künstlicher Intelligenz. Wir reden nicht nur über KI, sondern setzen sie auch selbst ein. Weitere Hilfsmittel und Publikationen von uns zum Thema finden Sie hier.
Enthaltene Dienstleistung(en):
Nehmen Sie Kontakt mit unseren Autorinnen und Autoren auf und profitieren Sie von deren Expertise:
David Rosenthal
david.rosenthal@vischer.com
+41 58 211 36 05